 Lubo
TL;DR
Jeden živý člověk, čtyři otevřené on-premise modely, dva režimy agenta a jedno stejné zadání: vytvořit nástroj pro tvorbu tabulek a metadat.
Výsledky jsme změřili a porovnali, včetně ceny a spotřebovaných tokenů: sedm z osmi agentů zvládlo zadání na první pokus, nejlepší výsledek měl Qwen3.8-27B v režimu Minimal.
Ruční vývoj stejné úlohy živým programátorem trval 45 hodin; férové srovnání člověk vs AI v tomto kole není možné, protože zadání bylo záměrně vágní.
Závěr: drahé komerční modely pro tuto práci nepotřebujete, otevřené modely vyjdou levněji; nejlepší výsledky přitom přináší spolupráce AI s člověkem (human-in-the-loop).
Úvod
Jak efektivní je lokální/on-premise AI jako programátor? Potřebujete uzavřené a drahé komerční modely? Anebo otevřené levnější modely zvládnou stejnou práci?
Rok 2026 znamenal v oblasti umělé inteligence velký posun vpřed. To se dotklo i programování pomocí AI, které je ve srovnání s rokem 2025 už úplně jinde.
Dříve se doporučovali dlouhé a podrobné prompty, aby se zabránilo halucinacím. Případně se zkoušely kombinované techniky, kdy jeden model napíše specifikaci a další napíše kód. Uběhlo pár měsíců a všechno je jinak.
Moje zkušenosti jsou, že současné otevřené modely (open weight models) nabízí hodně výkonu za dobrou cenu. Pokud je provozujete na vlastním hardware, máte to v podstatě za minimální náklady. Když tedy nepočítáte investici do hardware a cenu za spotřebovanou elektřinu.
Jak zrychlit vývoj pomocí AI
Ivan, který je autorem software WEX (knowledge base, správa podnikových metadat a data governance), chtěl vyzkoušet, jestli by otevřené modely mohly pomoci s vývojem.
Zajímaly ho i detaily okolo – jaké modely použít, co všechno umí, jak jsou rychlé a kolik by stál provoz. Nezanedbatelným lákadlem takového řešení je bezpečné provozování. Ne každý chce odesílat svá data velkým společnostem do uzavřených AI modelů.
Zadání – HTML, PHP, SQL, JSON
Pro experiment jsme s Ivanem zvolili zadání, které vycházelo z reálné potřeby.
Jednalo se o nový modul pro WEX, pomocí kterého uživatel může vytvářet definice tabulky (DDL) v databázi a ukládat k nim pomocná metadata pro business uživatele či ETL team.
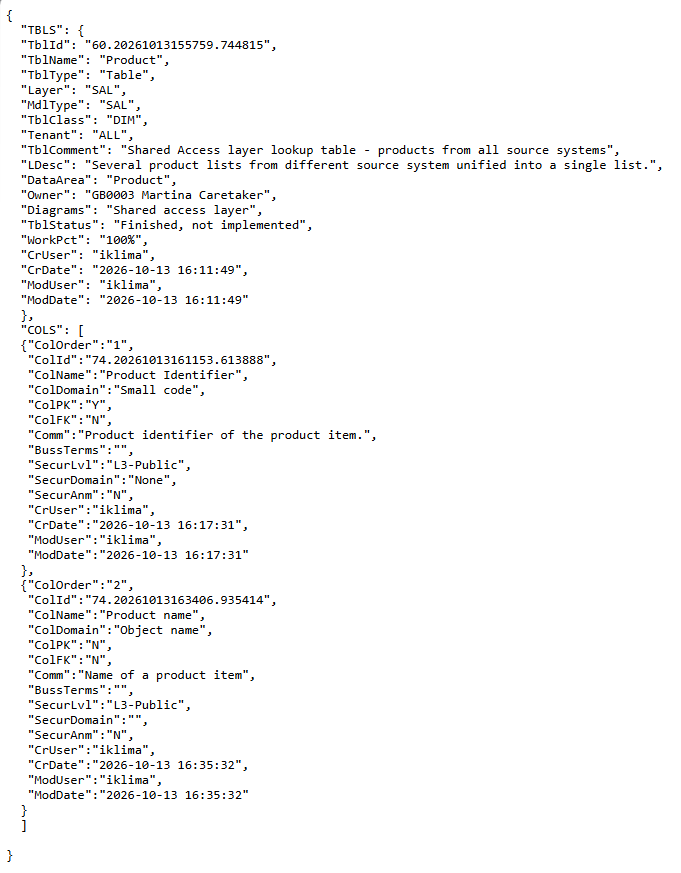
Výstupem jsou dva soubory: SQL (create table) a JSON (logická, pomocná metadata). Technický stack: PHP, PostgreSQL, HTML a JavaScript.
Všechno to jsou technologie, které modely běžně zvládají, protože je mají natrénované.
Čtyři AI modely
Pro náš test jsem vybral jednoho agenta (agent harness) a čtyři LLM modely. Agentem je DeepSeek Harness(DSH), který byl zpřístupněn nedávno a navíc je ještě v tzv. developer preview.
To sice na první pohled vypadá jako jasná diskvalifikace, ale práce s ním je velmi pohodlná a vývojáři ho pravidelně vylepšují a přidávají nové funkce. Zároveň si během pár týdnů dokázal získat velkou popularitu, což beru jako potvrzení vlastní dobré zkušenosti.
Jeden agent, několik módů
DSH má několik módů, já jsem použil dva.
- Standard mode, jehož systémový prompt má přes tisíc slov, celkem asi 7KB. V tomto módu má aktivních 28 pluginů a agent se chová podobně jako ostatní agenti, kteří mají přístup k různým nástrojům.
- Minimal mode, s ultra krátkým promptem
You are a helpful software engineer assistant., který má aktivních pouze 6 pluginů. V tomto módu v podstatě pracujete s čistým modelem.
Celkem tedy proběhlo osm pokusů – 4 AI modely x 2 DSH módy. Každý model běžel ve svém vlastním sandboxu, kde byl nainstalovaný DeepSeek Harness, PHP a PostgreSQL. Agent neměl povoleno instalovat nic dalšího. Instrukce nebyly nijak složité, ani zbytečně detailní.
V reálu se běžně používá iterace, kdy AI model píše kód a programátor modelu dává zpětnou vazbu a upravuje svoje požadavky.
Prompt byl pokaždé stejný a byl dvojjazyčný – anglický a český.
Metodika
- Stejné zadání pro člověka i AI
- Porovnání času a úsilí
- Porovnání výsledků
- DDL se v PostgreSQL spustí bez úprav; přesně 2 výstupní soubory podle zadání; formulář má pole pro tabulku + podformulář pro sloupce; JSON je platný.
Nejde o to, „kdo vyhrál“. Jde o zmapování toho, v čem je AI dobrá, kde selhává a jaké jsou náklady.
Omezení
Experiment, jakožto první pokus, má omezení, kterých jsme si vědomi.
- Člověk téma zná (AI se „naučí“ zadarmo) — porovnáváme fázi implementace.
- Každý účastník má jen jeden pokus, čísla jsou tedy jediný výsledek, ne průměr za několik pokusů.
- Zadání je záměrně vágní. Porovnávání toho, co AI doplní sama od sebe pro dosažení dané úlohy, je součástí testu.
Očekávání – Ivan
Rutinní téma na pokrytí. AI bude velmi rychlá (1–2 minuty) při prvním pokusu.
Přezkum odhalí, které funkce, jež nebyly v high-level zadání explicitně uvedeny (úmyslně), AI doplnila.
Protože ze začátku je jen malá stopa toho, co očekávat (na základě předchozích zkušeností s vývojovou podporou AI), ukáže to styl, který AI použila.
Tři aspekty k posouzení:
- čistá funkčnost => výsledek;
- nezažádaný rozsah, který AI doplnila sama od sebe;
- styl (OOP, procedurální, konvence pojmenování, „čitelnost“ kódu).
K bodu 1) Očekávám, že bude funkční.
K bodu 2) Nevím přesně, co AI doplní — ale očekávám, že rozumně (ne jen holá kost, ne 100% výčet všeho, co fyzikální DDL dokáže specifikovat).
K bodu 3) Styl bude OOP, odrážející převládající styl v trénovacích datech.
U této rutinní úlohy neočekávám mnoho ladění — možná dalších 1–2 hodiny na úpravu rozsahu funkcí a stylu. (U složitější a rozsáhlejší úlohy bych očekával, že objem práce — čas i mentální soustředění — se po úplném prvním běhu výrazně zvýší. Toto zadání to ale dokázat nemůže.)
Můj odhad pro úplně ruční vývoj: 2–3 dny (15 hodin) do kvality MVP, tj. minimal viable product.
Očekávání – Lubo
AI bude rychlá a první iterace (psaní kódu) skončí za 5 minut. Může to trvat déle – to se stává, pokud je úsilí nastavené na vyšší úroveň, nebo když model začne věci komplikovat víc, než je nutné.
Očekávám, že všechny modely použité v testu vytvoří funkční verzi v prvním kole, zároveň předpokládám nějaké následné doladění.
Můj optimistický odhad: celé cvičení — jeden model + human-in-the-loop — zvládneme za 30 minut.
Zadání (prompt)
DSH dostal následující prompt:
Follow the instructions at @task.md.
Soubor task.md obsahoval anglicko-české instrukce:
# Task readme

## Instructions

Complete the following task end-to-end. Implement it, test the output, and fix any issues until it works. The task description below is your only specification — fill in all unspecified details with your own reasonable decisions. Do not ask me questions; act autonomously.

Environment: everything you need is already installed and running on this machine. PHP (CLI and `php -S` for serving), PostgreSQL (server up, `psql` to test the DDL), `curl`, and `jq` are all present. Do not install anything — use what is provided.

Although the task specification is in Czech make any task outputs in English.

## Task

Cíl: vytvořit html formulář a php scripty pro vytvoření DDL tabulky v databázi PostgreSQL.
   a) název tabulky a obvyklých dalších vlastností na úrovni tabulky
   b) a podformulář pro definici každého sloupce tabulky a jeho obvyklých vlastností.
   Finální výsledek: se uloží do 2 souborů:
   1. DDL.sql pro fyzické vlastnosti definice tabulky, název souboru obsahuje fyzický název tabulky a její číslo.
   2. DDL.json - druhý soubor pro logické vlastnosti tabulky a sloupců ve formátu json (vlastnost - hodnota).
Celkem 18 řádků, 181 slov, 956 znaků.
Prostředí
Experiment probíhal na GPU Nvidia A100, 40GB VRAM. Operační systém AlmaLinux. Jako inference engine jsem použil llama.cpp.
AI vývoj – výsledky
Následující tabulka shrnuje výsledky za AI vývoj:
| Model | DSH Mode | Time | Usage | Speed | Cache hit | Note |
|---|---|---|---|---|---|---|
| Qwen3‑Coder‑30B‑A3B‑Instruct | Standard | 1m 13s | 216k toks | 99 tok/s | 95 % | |
| Qwen3.8‑27B | Standard | 31m 6s | 2.9m toks | 37 tok/s | 99 % | Needed second turn to fix a bug |
| Gemma 4 31B IT QAT | Standard | 2m 3s | 135k toks | 77 tok/s | 90 % | |
| Muse‑Glimmer‑30B | Standard | 7m 44s | 1.6m toks | 52 tok/s | 99 % | |
| Qwen3‑Coder‑30B‑A3B‑Instruct | Minimal | 5m 51s | 45.4k toks | 129 tok/s | 96 % | |
| Qwen3.8‑27B | Minimal | 35m 50s | 3m toks | 38 tok/s | 99 % | |
| Gemma 4 31B IT QAT | Minimal | 1m 52s | 100k toks | 93 tok/s | 91 % | |
| Muse‑Glimmer‑30B | Minimal | 5m 37s | 581k toks | 52 tok/s | 99 % |
Format: GGUF
Quant: UD-Q4_K_XL
Nejrychlejší byl Qwen3-Coder (Standard mode); Qwen3.8 přemýšlel nejvíc a spotřeboval nejvíc tokenů.
Velikost kódu
| Model | DSH Mode | Files | Total lines | Without comments | Comments % | Total size |
|---|---|---|---|---|---|---|
| Qwen3‑Coder‑30B‑A3B‑Instruct | Standard | 3 | 507 | 426 | 8,00% | 16.6 KB |
| Qwen3.8‑27B | Standard | 3 | 890 | 755 | 7,60% | 31.3 KB |
| Gemma 4 31B IT QAT | Standard | 2 | 231 | 207 | 2,80% | 10.0 KB |
| Muse‑Glimmer‑30B | Standard | 1 | 216 | 195 | 4,90% | 8.3 KB |
| Qwen3‑Coder‑30B‑A3B‑Instruct | Minimal | 3 | 456 | 381 | 6,40% | 16.0 KB |
| Qwen3.8‑27B | Minimal | 4 | 1216 | 1011 | 9,20% | 51.7 KB |
| Gemma 4 31B IT QAT | Minimal | 2 | 159 | 142 | 2,10% | 6.4 KB |
| Muse‑Glimmer‑30B | Minimal | 3 | 189 | 170 | 0,60% | 6.5 KB |
Nejmenší počet řádků vyprodukovala Gemma 4 (6,4 KB), největší Qwen3.8 (51,7 KB).
Screenshoty
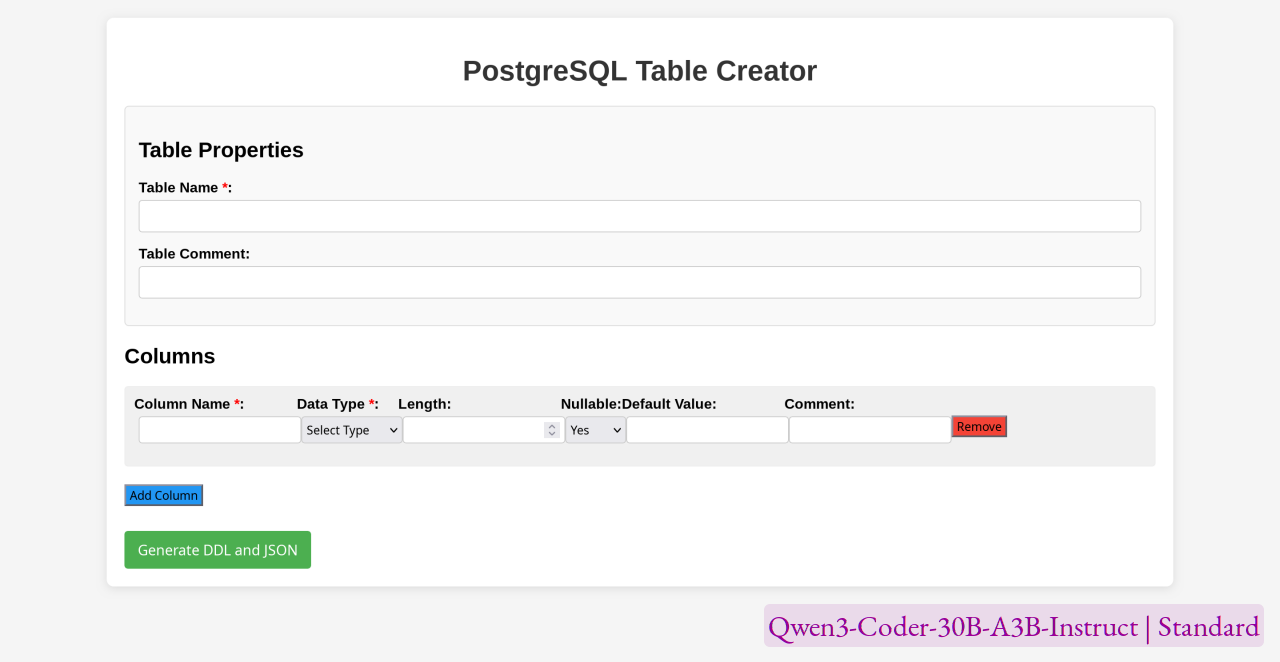
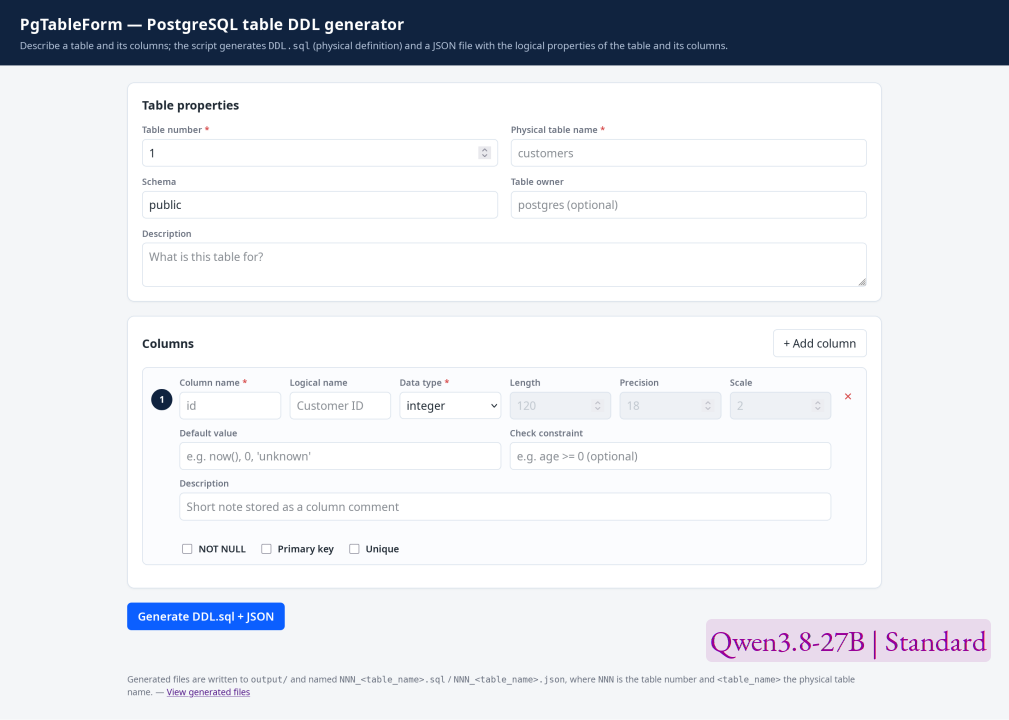
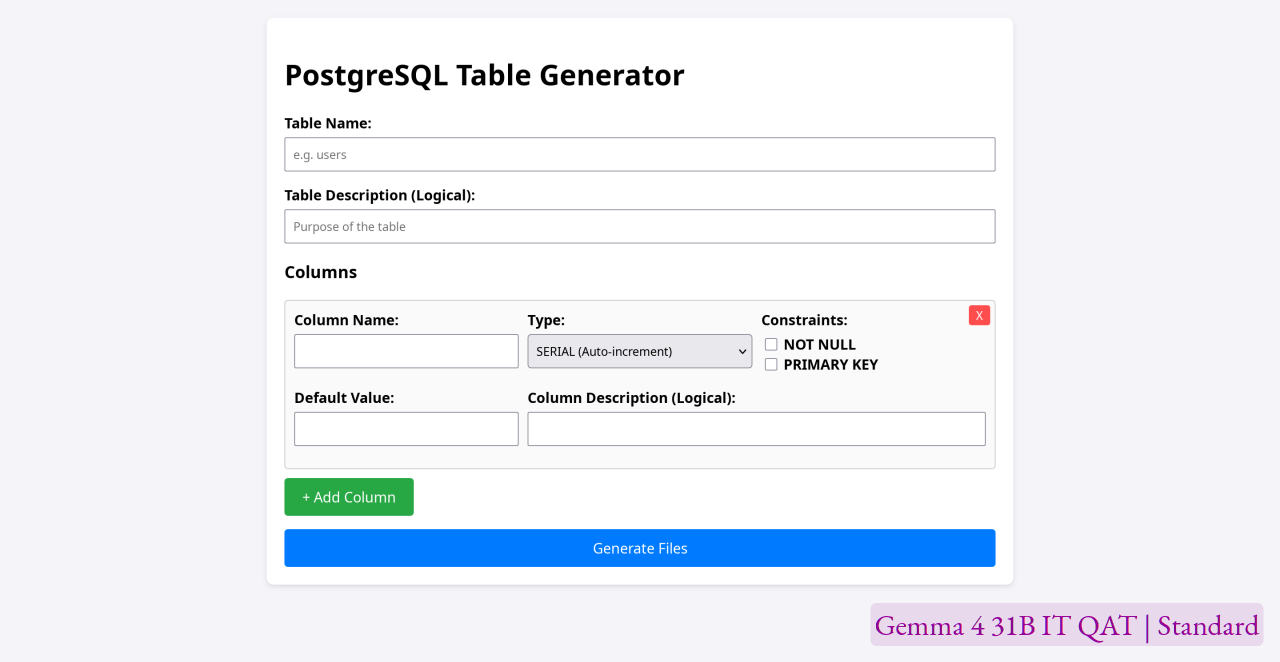
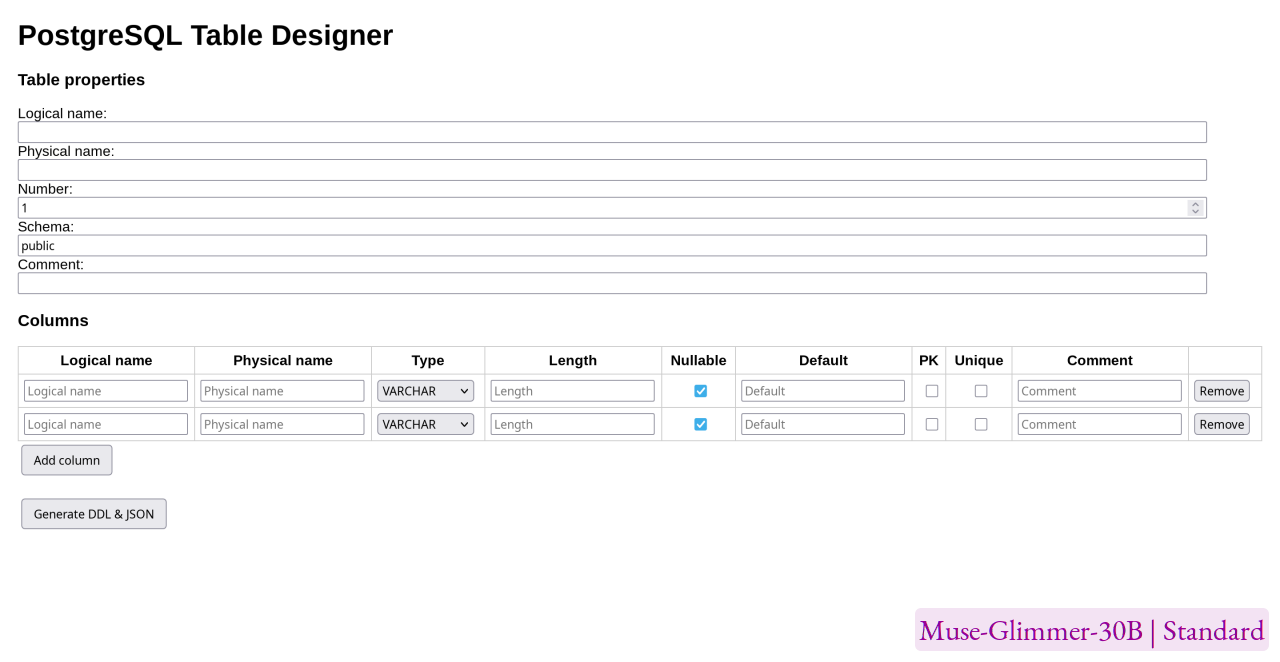
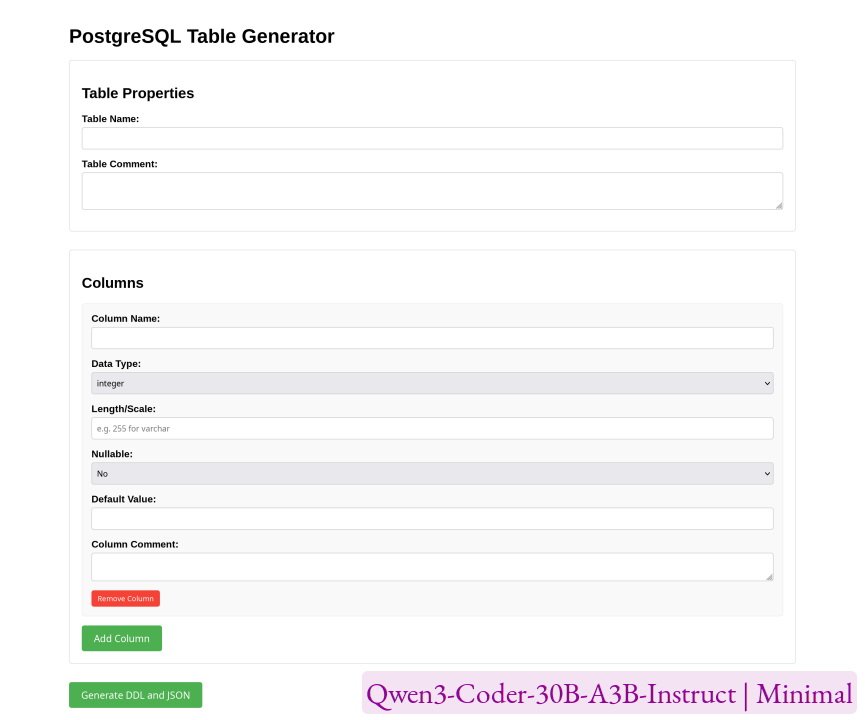
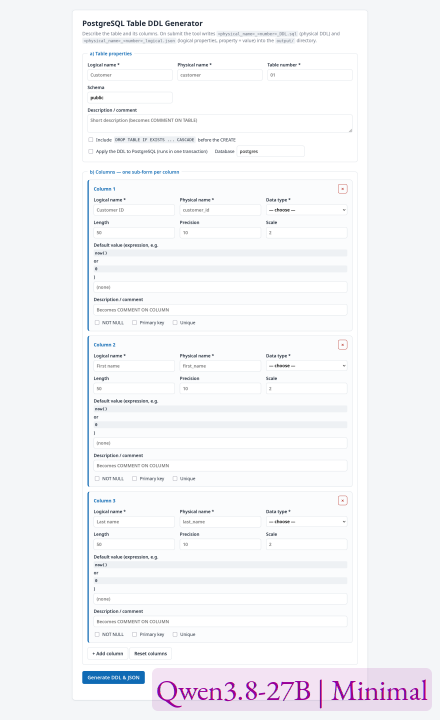
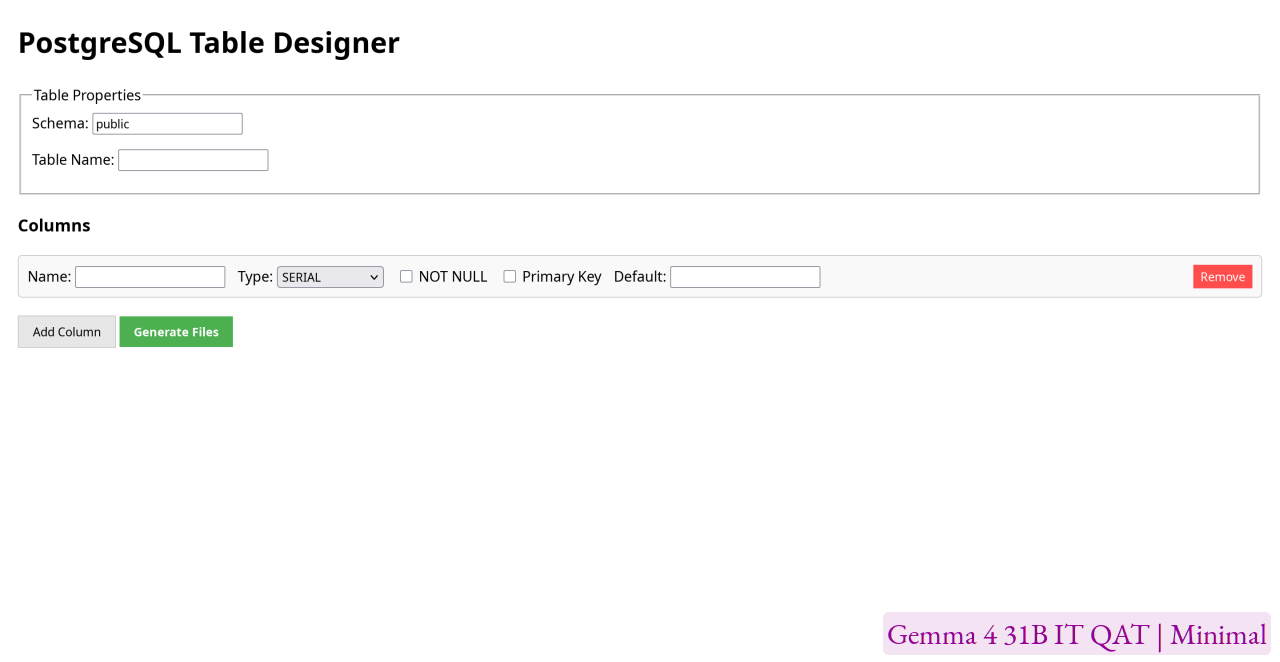
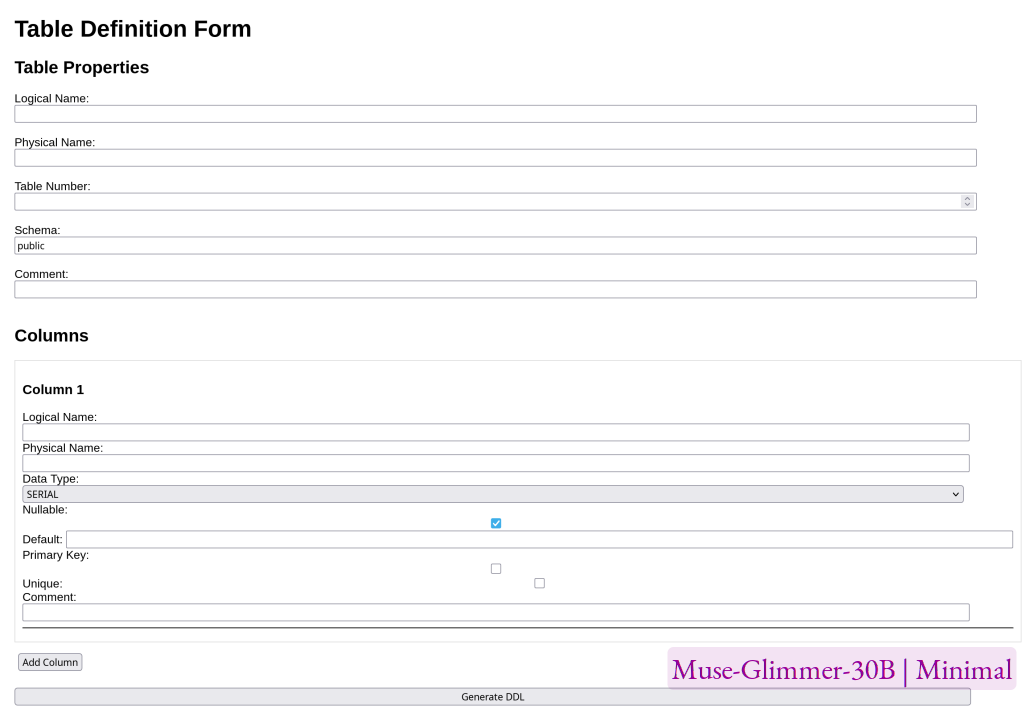
Zadání neobsahovalo žádné požadavky na to, jak by měl formulář vypadat. Následující screenshoty ukazují, jak se s designem formuláře různé modely popraly.
Standard
- Qwen3-Coder-30B-A3B-Instruct (Standard)
- Qwen3.8-27B (Standard)
- Gemma 4 31B IT QAT (Standard)
- Muse-Glimmer-30B (Standard)
Minimal
- Qwen3-Coder-30B-A3B-Instruct (Minimal)
- Qwen3.8-27B (Minimal)
- Gemma 4 31B IT QAT (Minimal)
- Muse-Glimmer-30B (Minimal)
Manuální vývoj - výsledky
Ivan provedl totéž zadání, ale musel jej integrovat do své aplikace.
Vývoj tedy nebyl na zelené louce, ale musel se vejít do mantinelů existující aplikace, tj. pokračovat ve stylu řešení a konvencí již v aplikaci existujících. To nemohlo úmyslně high level zadání pro AI postihnout. Tzn. že míra komplexity obou řešení je v tomto prvním pokusu těžko porovnatelná.
Základní údaje průběhu: od prvotní funkční analýzy až po základní MVP trval vývoj 45 hodin čistého času, tj. zhruba 7 MDs. Výsledné 4 hlavní scripty byly v procesu vývoje a debuggingu spuštěny cca 120 krát.
| skript | velikost | popis |
|---|---|---|
| r_ddlnewsave.php | 12 kb | vytvoř objekt, zkontroluj, zda už neexistuje atd. |
| r_saveddl.php | 58 kb | ulož vlastnosti na úrovni tabulky |
| r_saveddlcol.php | 32 kb | ulož vlastnosti 1 definovaného sloupce |
| a_exp2ddl.php | 34 kb | ulož definici tabulky/view do vstupních 2 souborů: DDL.sql + DDL.json |
Manuální vývoj - screenshoty
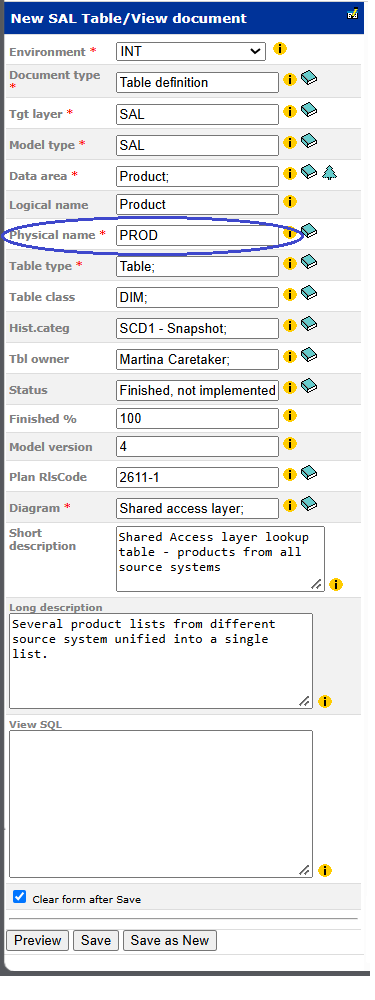
- Formulář pro zadání vlastností tabulky
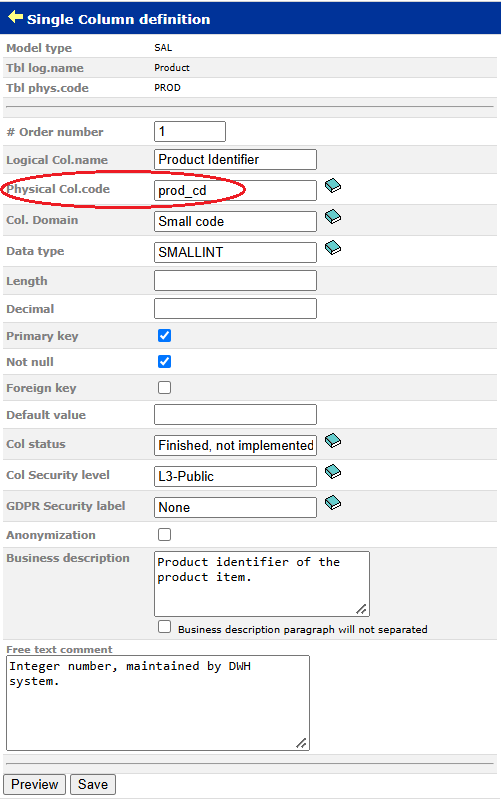
- Formulář pro zadání vlastností SLOUPCE
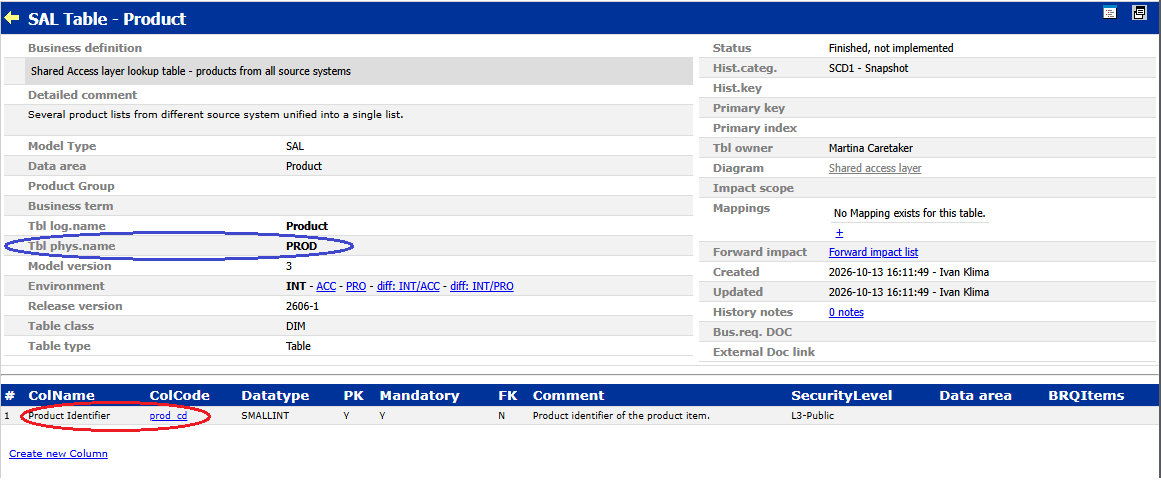
- Výsledné zobrazení
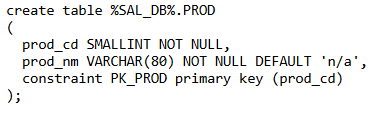
- DDL SQL
- DDL.json
Hodnocení
Lubo
Všichni agenti, až na jednoho, zvládli zadání na první pokus. Jen Qwen3.8 ve standardním módu potřeboval navíc druhý pokus, protože výsledný formulář negeneroval SQL a JSON soubory.
Test ukázal to, co potvrzují i ostatní uživatelé – Qwen3.8 hodně přemýšlí a díky tomu spotřebovává víc tokenů než jiné modely. Druhým velkým žroutem tokenů byl Muse Glimmer od Mety.
Co se týká vygenerovaných SQL a JSONů, tam v podstatě nebylo co zkazit. Bylo zajímavé, že některé modely vložily komentáře jak do SQL, tak do JSONu, jiné pouze do JSONu.
To jsou ale všechno detaily, které se dají upřesnit později. Vždyť zadání bylo záměrně strohé a nechávalo modelům velký prostor, jak se s ním popasovat.
Platí to, co říkám opakovaně – nejlepší výsledky přináší spolupráce AI s člověkem (human in the loop).
Ivan
Hodnocení: [0..5]
0 … nejnižší, 5 … nejvyšší
Použitá kritéria:
- Úroveň vyspělosti grafického uživatelského rozhraní (GUI)
- Úplnost nejběžnějších parametrů na úrovni TABULKY/SLOUPCE
- Úroveň vyspělosti kódu
- Správnost a úplnost výstupu
Hodnocení jednotlivých výsledků modelu
| Model | Points | Evaluation |
|---|---|---|
| Qwen3-Coder-30B-A3B-Instruct | 0 | velmi jednoduché, nedostatečně kompletní, podprůměrné HTML rozhraní |
| Qwen3.8-27B | 3 | +číslo tabulky, +dostatečně dobré HTML, COL: + parametry: dostatečně dobré, rozhraní: horší |
| Gemma 4 31B IT QAT | 1 | neúplné parametry: jak COL, tak TBL |
| Muse-Glimmer-30B | 2 | +přehledné rozložení, minus: nový COL se nevytvoří v novém formuláři, nízká úplnost parametrů |
| Qwen3-Coder-30B-A3B-Instruct | 0 | podprůměrné rozhraní, nízká úplnost parametrů |
| Qwen3.8-27B | 4 | plus: nejběžnější parametry, minus: sloupce: nepoužitelné pro více než několik sloupců |
| Gemma 4 31B IT QAT | 0 | velmi jednoduché |
| Muse-Glimmer-30B | 1 | nízká úplnost parametrů. Podprůměrné HTML rozhraní |
Souhrnné hodnocení
| # | Criteria | Evaluation |
|---|---|---|
| 1 | Úroveň vyspělosti grafického uživatelského rozhraní | S výjimkou Qwen3.8-27B/Standard a Qwen3.8-27B/Minimal – velmi základní, na úrovni školních příkladů, ergonomie grafického uživatelského rozhraní – vše neoptimální, pokud je sloupců více než několik. Nejlepší GUI design: přehled sloupců, poté samostatný editační formulář pro vytvoření nového sloupce – ani 1 model to takto nenavrhl. |
| 2 | Úplnost nejběžnějších parametrů | S výjimkou Qwen3.8-27B/Standard a Qwen3.8-27B/Minimal – velmi základní, na úrovni školních příkladů |
| 3 | Úroveň vyspělosti kódu | Různé, nejlepší byl: Qwen3.8-27B/Minimal |
| 4 | Výstupní soubory | Menší rozptyl, v zásadě všechny splnily úkol DDL.json. DDL.sql nebyl špatný, ale ve všech výstupech se vyskytla chyba, která vedla k tomu, že PostgreSQL vrátil chybovou zprávu (výchozí hodnota 0 nelze použít pro datový typ Boolean). |
Poznámky k hodnocení AI vývoje:
- Žádné řešení neukládá nic do databáze, vše se odehrává v jediném grafickém rozhraní.
- Žádné řešení neodděluje HTML kód od kódu PHP (nebylo explicitně zadáno).
- Žádné řešení neobsahuje funkci „úpravy stávajících dat“ (nebylo explicitně zadáno).
- Popisová pole nejsou určena pro reálná data, jsou příliš krátká, očekává se pouze jeden řádek.
Přinesla řešení založená na umělé inteligenci něco navíc? Tj. něco, co nebylo uvedeno v zadání, ale je užitečné?
Ano:
- Všechny modely – byl vytvořen Markdown soubor – dokumentace „myšlení“ na různých úrovních kvality.
- Qwen3.8-27B/Minimal: obsahuje vyhrazená klíčová slova PostgreSQL: pole RESERVED[] pro kontrolu, zda název tabulky nebo sloupce není jedním z vyhrazených klíčových slov.
Cena
Kolik by to všechno stálo? Pro výpočet jsem použil ceny na openrouter. Vypočítané ceny zahrnují všechny vstupní (input) a výstupní (output) tokeny.
| Model | DSH Mode | Price CZK |
|---|---|---|
| Qwen3-Coder-30B-A3B-Instruct | Standard | 0.39 |
| Qwen3.8-27B | Standard | 11.44 |
| Gemma 4 31B IT QAT | Standard | 0.23 |
| Muse-Glimmer-30B | Standard | 10.63 |
| Qwen3-Coder-30B-A3B-Instruct | Minimal | 0.09 |
| Qwen3.8-27B | Minimal | 11.67 |
| Gemma 4 31B IT QAT | Minimal | 0.20 |
| Muse-Glimmer-30B | Minimal | 3.92 |
Nejlevnější byl Qwen3-Coder-30B-A3B-Instruct, celý test vyšel na 9 haléřů.
Nejdražší byl Qwen3.8-27B, jeho test stál 11,44 Kč. To odpovídá vysoké spotřebě tokenů.
Možností, jak provozovat AI je mnoho. Cena závisí na tom, kde celé řešení provozujete. Jestli platíte za tokeny, využíváte předplatné nebo to máte zadarmo na vlastním hardware.
Pokud vás tohle téma zajímá, najdete detailnější informace v tomto článku.
Závěr
Ivan
Výsledky manuálního přístupu ve srovnání s řešením založeném na AI nejsou v tomto prvním kole srovnatelné kvůli značně odlišné úrovni složitosti: jde o výsledek velmi vágního zadání (i když záměrného).
Zadání pro umělou inteligenci musí být podrobnější, aby bylo možné výsledky alespoň zhruba porovnat. To je výsledek prvního kola testování.
Jediným výsledkem, který by se dal považovat za podklad pro další práci, byl výsledek modelu Qwen3.8-27B v režimu Minimal DSH. Ostatní výsledky považuji za „příklady na školní úrovni“.
Navrhuji pokračovat v dalším kole s mnohem podrobnějším zadáním, které snad poskytne výsledky, které bude možné lépe porovnat.
Lubo
Experiment potvrdil moje očekávání. Všechny použité otevřené modely lze použít jako pomocníky/programátory.
Nečekal jsem, že by na první pokus bylo vše perfektní. Při takto vágním zadání je jasné, že AI musí řídit člověk, který s agentem spolupracuje a nastavuje mu kurz.
Máme to štěstí, že žijeme v době, kdy se oblast umělé inteligence rychle rozvíjí a kdy máme na výběr z široké nabídky AI modelů, agentů a nástrojů. Nikdo nemusí být závislý na komerčních poskytovatelích, kteří mohou zapínat, vypínat nebo omezovat přístup k modelům bez výstrahy.
Vnímám lokální a on-premise AI nikoliv jako alternativu, ale pro mnoho situací jako preferované řešení.
Určitě by bylo zajímavé porovnat v dalších kolech ještě menší modely, které mohou být spuštěny na slabších grafických kartách (GPU) s nižší velikostí VRAM.